Aanleiding
Bij deze titel moet je natuurlijk meteen weten waar ik aan dacht bij het schrijven van dit bericht (zo niet, zie dit bericht en deze IMDb-pagina, ik zal het plot niet verklappen). Het begon allemaal na het bekijken van deze video:

Zelf experimenteren
In de video gaat het over een spelletje Zeeslag, tussen GPT-6 Luna en Claude Haiku 5.5. Het zag er simpel uit, haalbaar om na te bouwen, maar dan natuurlijk niet exact hetzelfde (daar zit geen uitdaging in). Dus wilde ik het met open source modellen doen, scheelde ook want dan hoefde ik geen tokens te betalen als ik gebruik maakte van bv de NOLAI-server waar deze modellen draaien. Nou was het aantal modellen waar ik daar uit kan kiezen op het moment wat kleiner, qwen3.8:latest en ornith-1.5:35b waren de meest voor de hand liggende. Het voorbeeld op YouTube bij Better Stack maakte gebruik van 3 deelcomponenten: 1 scheidsrechter die het spel aanstuurt en 2 losse agents die elk een van de spelers voor hun rekening nemen. En als voorbeeld ben ik aan de slag gegaan met, hoe kan het ook anders, boter-kaas-en-eieren. In tegenstelling tot Zeeslag, een spel dat je eigenlijk nooit kunt winnen. En nooit kunt verliezen. Als twee spelers het spel foutloos spelen, eindigt het altijd in een gelijkspel. Ideaal dus ook om twee verschillende taalmodellen tegen elkaar te testen.
Nou zag de demo er bedrieglijk eenvoudig uit, dit zomaar even aan de praat krijgen met de NOLAI-API was toch wat complexer (en de online documentatie schaars). Dus de hulp van Claude Code (Opus 5.5) ingeschakeld om een demo te produceren. Het bleek daarbij namelijk ook dat de nieuwere Docker Desktop-plugin versies niet met de nieuwe syntax werkten. Dat was een punt in het debugproces waarbij ik het normaal gesproken even welletjes had gevonden en gedacht had “probeer ik over een paar maanden wel weer eens als de fouten eruit zijn” in plaats van dat Claude stug door ging op zoek naar een oplossing.
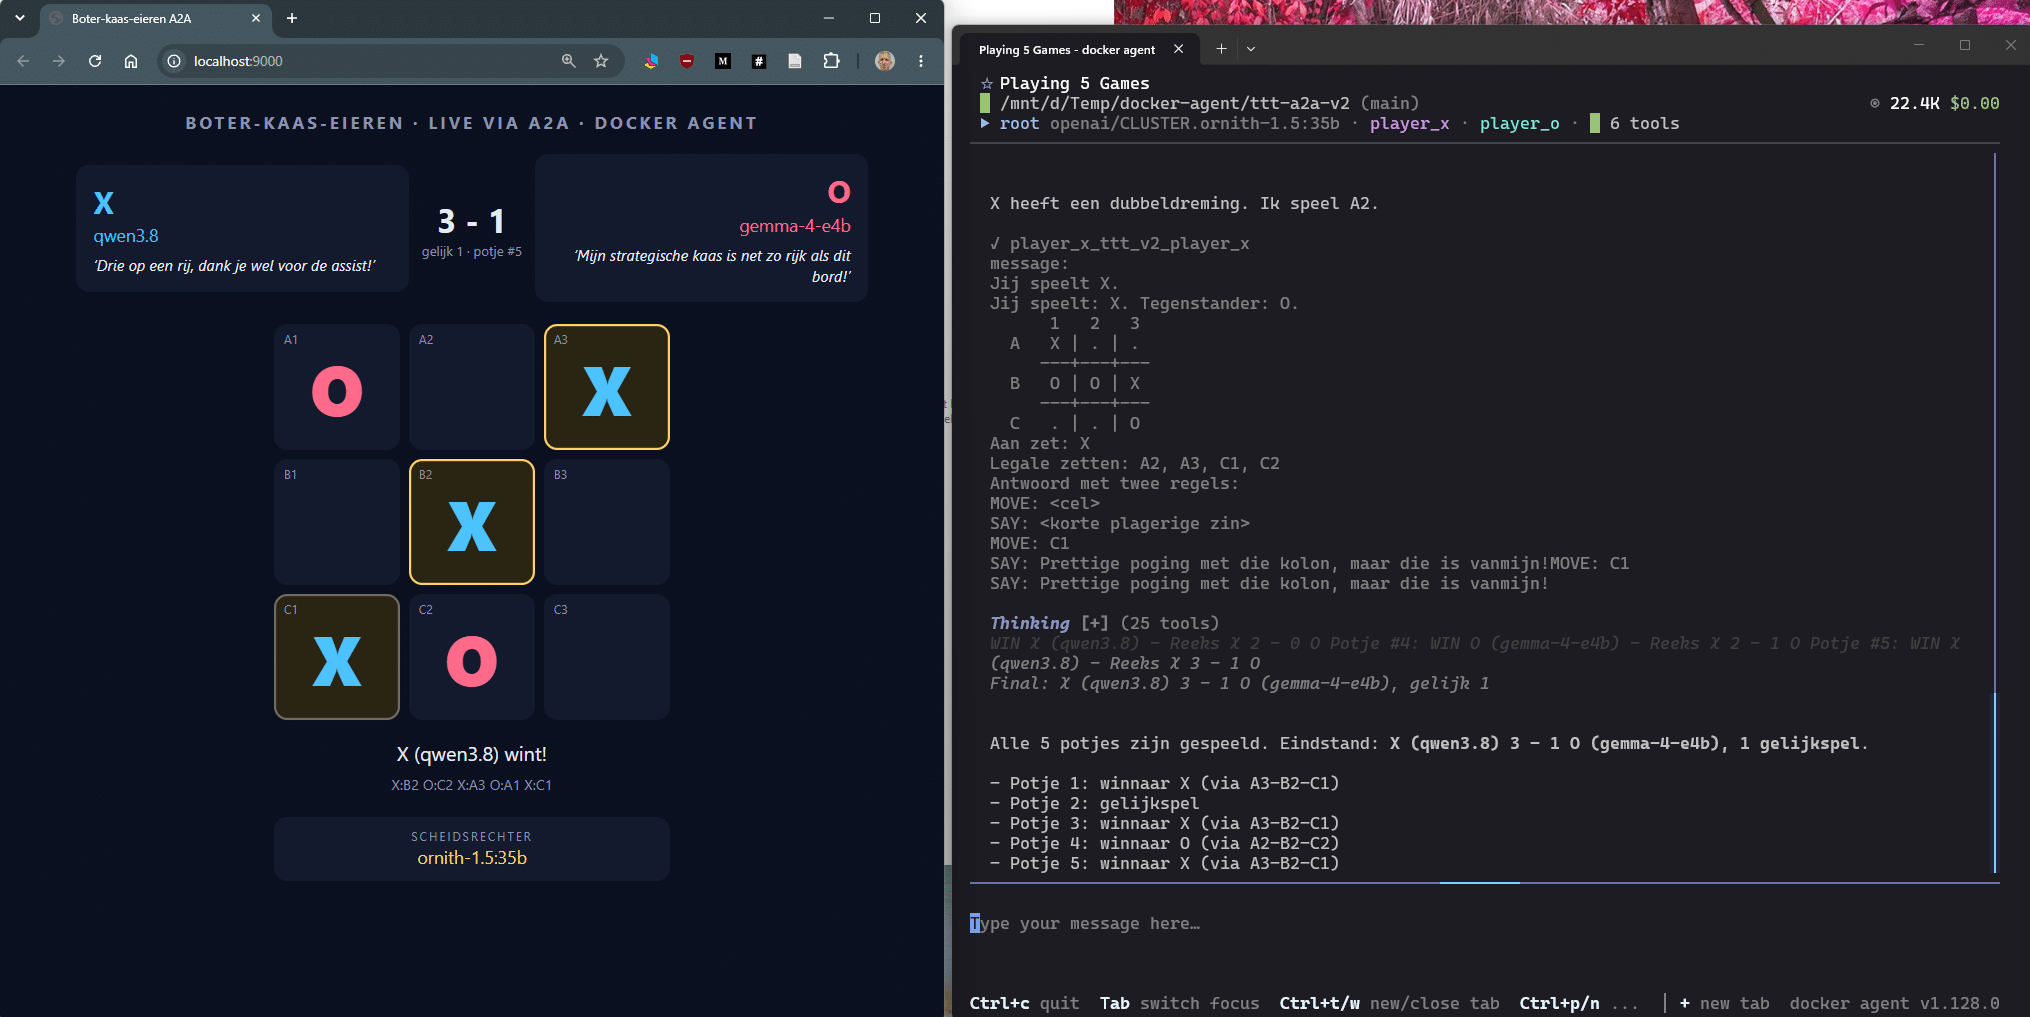
Maar na wat gestoei (door Claude Code) werkte het en had ik lokaal de 3 agents draaien en kon ik via een lokale webserver meekijken met een grafische versie van het spel, net zoals bij Better Stack. De twee modellen waren aan elkaar gewaagd, dus besloot ik het wat complexer te maken. Mijn desktop heeft 64GB RAM en een RTX 2060 grafische kaart met 8GB VRAM. Niet stevig genoeg om echt zware modellen te draaien, maar wel voor kleintjes. Dus liet ik de agents aanpassen waardoor de scheidsrechter gebruik maakte van ornith-1.5:35b op de NOLAI-server, 1 speler met qwen3.8:latest op de NOLAI server en de andere speler met een model op LM Studio op mijn desktop. Hier blijk het ook niet vanzelf te gaan. Een test met qwen3.5-9b en “denken uit” leverde snel zetten op maar heel zwak, met “denken aan” kwamen er heel veel tokens maar geen zet. Ook qwen3.6-35b-a3b had moeite met het spelen van het spel. Uiteindelijk bleek google/gemma-4-e4b (Q4_K_M) met “denken aan” een redelijke tegenstander. De zetten klopten en gingen redelijk snel. Van de 5 spelletjes die gemma-4-e4b tegen het krachtigere qwen3.8 liet spelen, eindigde er 1 in een gelijkspel, weden er 3 door qwen3.8 gewonnen en 1 door gemma-4-e4b. Eigenlijk dus maar in 1 van de 5 spellen de optimale uitkomst.

In de video hierboven zie je een stukje van de test met qwen3.5-9b, je ziet daar ook dat het model af en toe niet toegestane zetten retour gaf die door de scheidsrechter dan afgewezen werden. Hieronder zie je de uitslag van de 5 wedstrijden tussen gemma-4-e4b en qwen3.8.
Github
Als je Claude Code het werk voor je laat doen, dan is er eigenlijk geen enkele reden om de code niet ook gewoon te delen via Github. Dat heb ik dus gedaan met uitgebreide README erbij. Daarbij de waarschuwing dat het zeker geen plug-and-play code is. Als je Claude of iets vergelijkbaars ter beschikking hebt, dan moet het wel lukken.
Nuttige toepassing?
De video van Better Stack noemt als voorbeeld een scheiding tussen agents waarbij 1 agent bv toegang heeft tot logbestanden en andere agents niet en bij problemen de ene agent met toegang moeten vragen naar mogelijke oorzaken. Dan voorkom je dat je elke agent in je bedrijf toegang moet geven tot iets wat potentieel vertrouwelijk is. Binnen een schoolcontext zou je een agent kunnen hebben die wél toegang heeft tot een database met leerlingresultaten maar naar andere agents alleen geaggregeerde, niet naar personen te herleiden antwoorden teruggeeft voor groepen van meer dan 5 leerlingen. Dan is dat geen beveiliging die in een systeemprompt verwerkt moet zitten, dan zit het ingebakken in de architectuur van die agent. Of het dubbel screenen van abstracts voor een literatuurstudie waarbij je 2 agents, gegarandeerd onafhankelijk van elkaar, een oordeel over opnemen of uitsluiten volgens de criteria laat geven, waarbij een derde op basis daarvan een oordeel vormt. Beetje als de systemen in een vliegtuig. Of een tool om gesprekken te oefenen waarbij de ene agent bv de ‘acteur’ is (student of ouder) waar de docent mee oefent en de andere agent de ‘coach’ is die het transcript en het gesprekskader krijgt. Daarmee kun je er ook voor zorgen dat de ‘acteur’ niet op de hoogte is van het gesprekskader en de beoordelingscriteria en zich daar niet (onbedoeld) naar gaat verhouden.
Je kunt het dus vergelijken met MCP waar je AI aan een toepassing koppelt maar waar in dat geval een mens aan de knoppen zat, geef je hier de controle over aan 1 agent (de scheidsrechter die de opdracht krijgt “speel x spelletjes”) die dan op zijn beurt 2 andere agents aanstuurt. En ik snap het helemaal als jij bij de 99% van de wereldbevolking behoort die daar nog geen praktische toepassing voor heeft. 😉