“AI maakt toegankelijk, maar sluit ook uit” luidt de titel van een Linkedinbericht van de HAN-collega’s van de academie voor IT en Mediadesign. Als je jezelf wilt professionaliseren op het gebied van toegankelijke AI moet je zeker dat bericht even lezen. In deze blogpost richt ik me op een medium dat voor vaak redelijk ontoegankelijk is ook als je wél de feitelijke tekst kunt lezen. En ook daar kan AI, mits je weet hoe, bij kan helpen.
Mag dit wel?
Laat ik die olifant eerst maar even adresseren: deze blogpost beschrijft (voor zover ik kan overzien) een tweetal grijze gebieden van toepassingen voor wat betreft de vraag of het wettelijk toegestaan is. Daarbij gaat het zowel om de vraag of de eerste stap (conversie naar voorleesversie) of de tweede stap (het opslaan van de audio) toegestaan is.
Zie het als een proof-of-concept en persoonlijk studieproject én als iets waarvan ik vind dat als we dan als onderwijs al geld gaan steken in AI, dit gewoon standaard voor alle studenten/leerlingen/medewerkers beschikbaar zou moeten komen.
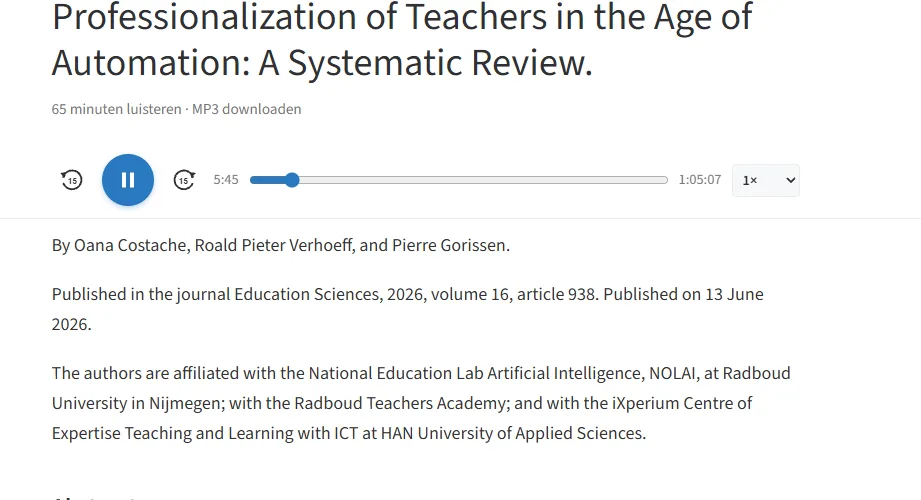
Het resultaat
Wil je het liever in een apart venster bekijken, klik dan hier.
De stappen
Ik heb de stappen uitgevoerd in Claude.ai en Opus 5.5 (hoog) maar het zal ongetwijfeld ook met andere modellen kunnen.
#0 Zoek een artikel op dat je wilt lezen
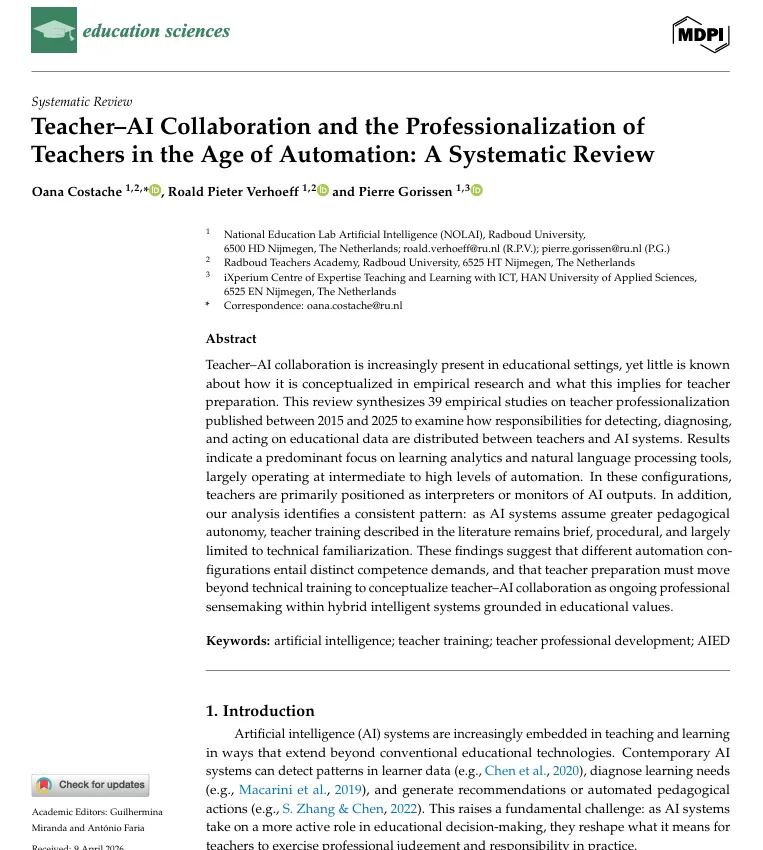
Als bron heb ik een artikel waar ik zelf co-auteur van ben genomen en dat te downloaden is vanaf deze website. Uiteraard vind ik dit niet het meest complex geschreven artikel dat je kunt vinden, maar ook hier snap ik absoluut dat het best ingewikkeld kan zijn om zo’n artikel te lezen als je niet gewend bent om de literatuurverwijzingen en de opmaak heen te lezen. Beiden hebben absoluut een doel, de tabellen en afbeeldingen eveneens. Nou kun je Adobe Acrobat of Microsoft Edge de PDF openen en dan laten voorlezen. Maar dat wordt absolute chaos en hou je gegarandeerd niet vol. Die omgevingen lezen namelijk letterlijk alles voor wat er op de pagina staat. Als je pech hebt, dan heb je een versie met een watermerk erin, regelnummers, paginanummers, etc.
Daar moeten we dus iets aan doen
#1 Laat Claude een voorleesversie maken
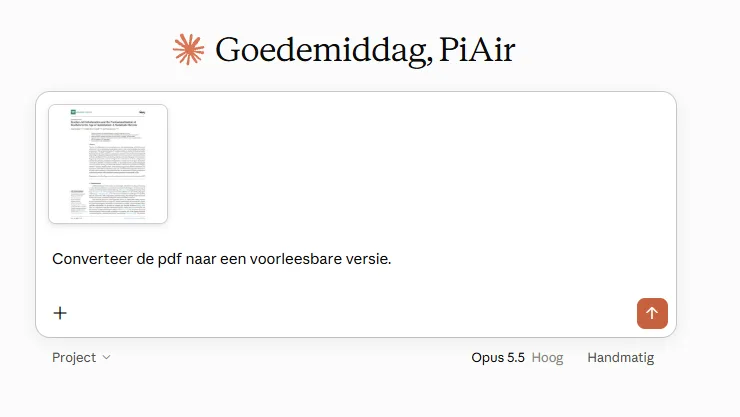
De prompt in Claude is simpel:
Converteer de pdf naar een voorleesbare versie.
Nou weet ik inmiddels niet 100% zeker of deze prompt goed werkt omdat Claude het al eens eerder voor me gedaan had en dus weet wat ik bedoel. Maar je zou ook kunnen proberen:
Converteer de pdf naar een voorleesbare versie: citaties eruit, afkortingen en symbolen uitgeschreven, figuren in woorden beschreven.
Ik kreeg het resultaat eerst als een .txt (platte tekst) bestand. Je kunt nu aan Claude vragen om het op te slaan als pdf en dan kun je hem in Microsoft Edge openen en daar laten voorlezen. Dat werkt prima en dan hoef je de volgende stap niet uit te voeren.
#2 Converteren naar MP3
Er zijn een paar online diensten die een tekstbestand naar MP3 omzetten, maar daar kwam ik niet ver genoeg mee voor een artikel van deze omvang. Edge-tts blijkt een niet gedocumenteerde, dus ook soms niet meer werkende, optie te hebben waarmee je de voorgelezen audio kunt opslaan. Claude legde uit hoe:
pip install edge-tts
edge-tts --list-voices
python tts_hervatbaar.py teacher-ai-collaboration.txt teacher-ai-collaboration.mp3

Om dit te kunnen doen moet je tts_hervatbaar.py downloaden uit deze ZIP. Het script heet hervatbaar omdat in eerste instantie een tijdelijk probleem met de netwerkverbinding er voor kon zorgen dat de conversie afbrak. Het conversiescript maakt ook een teacher-ai-collaboration.srt bestand dat tekst en tijdcodes aan elkaar verbindt.
#3 HTML-player genereren
Ook hier geldt dat je niet alles zelf hoeft te kunnen.
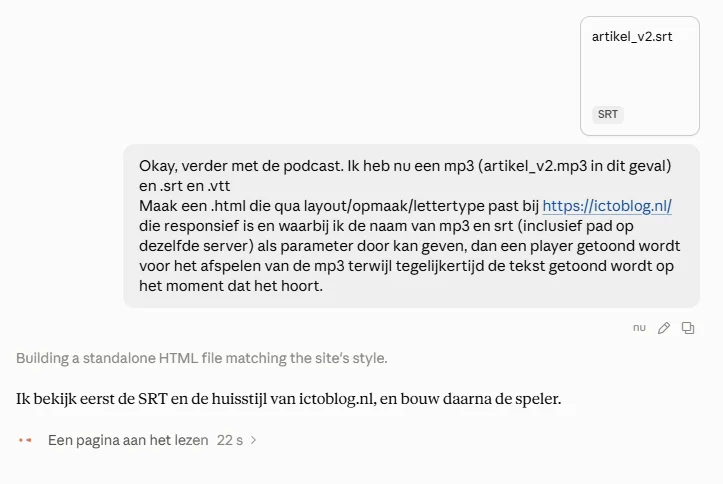
Ik heb Claude een “meelezen.html” (opgenomen in de ZIP) laten maken die ik kan embedden in een bericht of die je als losse player kunt gebruiken door er een mp3, een srt, een txt aan door te geven. Kun je desgewenst natuurlijk helemaal in de door jezelf gewenste opmaak laten genereren.
Is het perfect?
Nee, natuurlijk niet. De tekst verwijst soms nog naar afbeeldingen die er niet meer zijn. De uitspraak van namen gaat vaak nog mis. Je bent nu alle verwijzingen naar bronnen kwijt, voor een onderzoeker een serieus probleem. Voor een doorsnee lezer die vooral wil weten wat er in het artikel staat in eerste instantie niet, maar je zou eigenlijk ook leraren/docenten/studenten willen opvoeden (professionaliseren?) op dat vlak.
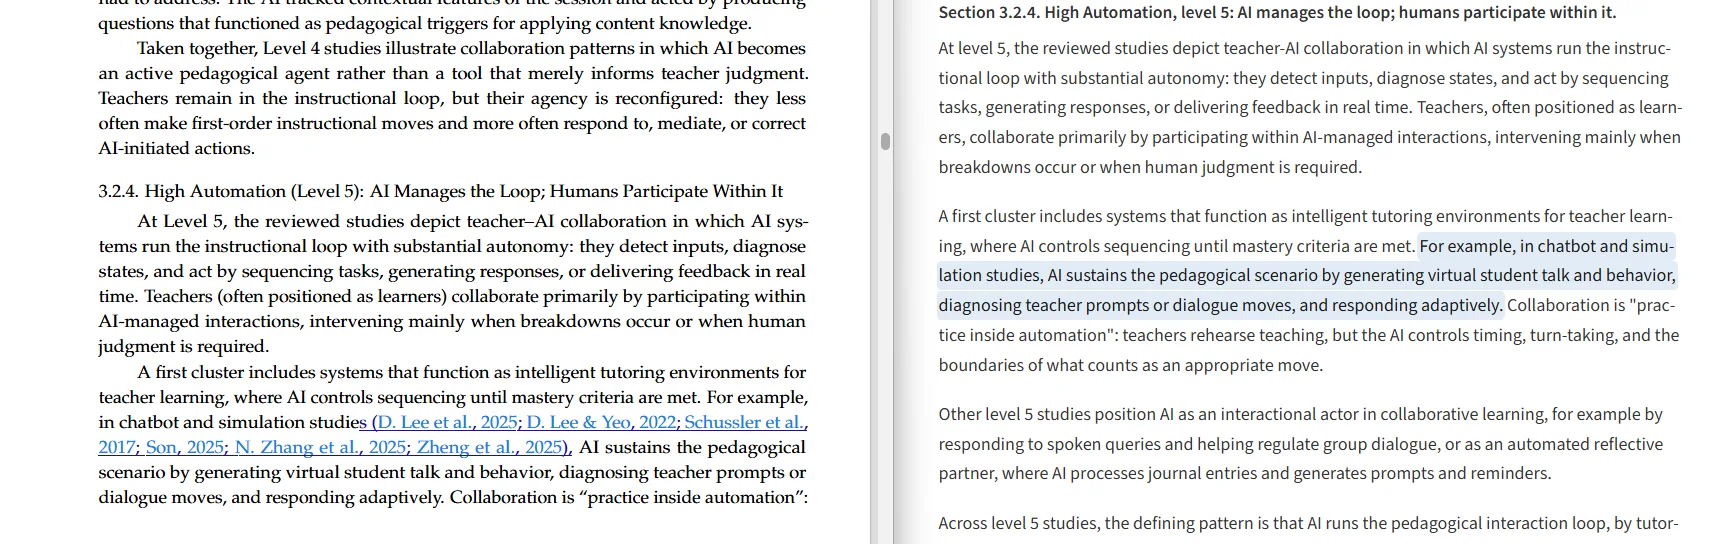
Het zou wat mij betreft nog wel een mooie uitbreiding aan de player (en het conversieproces) zijn wat mij betreft. Dus een voorleesversie die zoals nu zorgt voor de audio, maar dan gecombineerd met een meeleesversie waar de afbeeldingen en tabellen wél nog in staan. Levert wat nieuwe uitdagingen op als je het resultaat dan ook weer toegankelijk wilt maken voor iemand die de tekst niet mee kan lezen.
Hoe dan ook, het is absoluut zo dat we energie moeten blijven steken in de leesvaardigheden van jongeren. Maar verwachten dat iedereen in staat is peer reviewed onderzoek tot zich te nemen gaat me toch net wat ver. Dan zijn hulpmiddelen om onderzoek te ontsluiten en toegankelijk te maken voor meer mensen wat mij betreft heel welkom.