Het vraagstuk
Nu er inmiddels zó veel verschillende taalmodellen zijn, is de vraag vaak niet meer “wat is het beste model?”, maar “wat het is het meest geschikte model voor mijn doel/vraag?”. Daarbij is er sinds kort een klasse van modellen bijgekomen, zogeheten System One-modellen, die die keuzes ook in educatieve context zeker niet gemakkelijker heeft gemaakt. Waar taalmodellen woord voor woord een antwoord formuleren, geven deze andere modellen (beslismodellen) een antwoord uit een vaste set antwoordtypes terug:
- keuze: het antwoord is één optie uit een lijst (bv ‘geldig’ of ‘ongeldig’ antwoord), met een kans (percentage) dat per optie;
score: kies een niveau op een geordende schaal, zoals 0, 1 of 2 punten;
- noul: de kans dat het antwoord op een ja/nee-vraag “ja” is.
Omdat ze geen lange teksten hoeven samen te stellen zijn de modellen in de regel snel. Jev van het bedrijf TypeSafe, aangekondigd in september 2026, zette deze categorie beslismodellen op de kaart. TypeSafe positioneerd het model nadrukkelijk tegenover de trage, redenerende taalmodellen. Jev is een gesloten en gehost model: je kunt het dus niet zelf op je server installeren, mroept het aan via een API van TypeSafe. De cijfers die TypeSafe noemt (een fractie van de prijs en tientallen keren sneller dan een groot taalmodel, bij vergelijkbare nauwkeurigheid) zijn cijfers van de leverancier zelf. Onafhankelijke metingen zijn er nog nauwelijks. Maar inmiddels zijn er wél al open source alternatieven voor Jev uitgebracht.
TypeSafe leverde ook een nieuw format voor de API. Waar voor normale chatmodellen meestal het OpenAI API formaat gevolgd wordt, gebruikt Jev een /v1/systemone endpoint. Ollama en LiteLLM hebben inmiddels ondersteuning voor dat endpoint. De aanroep doet ertoe. Behandel je een beslismodel als chatmodel, dan gaat het eerst lang “nadenken” en levert het soms niets bruikbaars op.
De NOLAI-server heeft op dit moment (oktober 2026) een aantal varianten op Jev draaien met open gewichten die hetzelfde API-formaat spreken als Jev.
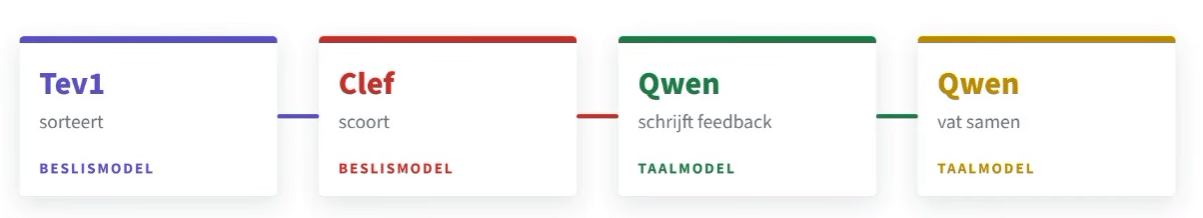
- Clef, van Cloudflare, is het zwaarste en het meest uitgebreide van de drie modellen. Een extra laagje bovenop het Qwen-model scoort alle toegestane antwoorden van alle vragen tegelijk; er wordt niets gegenereerd. Omdat het de vision-onderdelen van Qwen houdt, kan Clef ook een poster of schermafbeelding beoordelen. Dat heb ik nog niet getest.
- Nimble van Bespokelab AI is een gefinetunede Qwen3.5-9B, bedoeld voor snelle classificatie van tekst.
- Tev1 van TogetherComputer is het lichtgewicht: een fine-tune van Qwen3.5 in 4B en 0,8B. Het werkt via
/v1/systemone, maar kan ook via een gewone chat-aanroep een optieletter teruggeven. Together AI noemt het zelf experimenteel. Maar dat zou je eigenlijk wel voor al deze modellen kunnen stellen.
Voor de demo gebruik ik daarnaast Qwen3.8 27B, een model van Alibaba. Het is een tamelijk allround taalmodel, niet helemaal te vergelijken met bv een Opus 5.5 dat binnen Claude draait op dit moment, maar goed genoeg. Ook in het Nederlands.
De casus
Ik kan niks met abstracte benchmarks voor modellen, het moet concreet en toepasbaar zijn. Dus wilde ik een concrete casus hebben. En eentje waarbij ik synthetische/fictieve data kon gebruiken. Het werd het volgende:
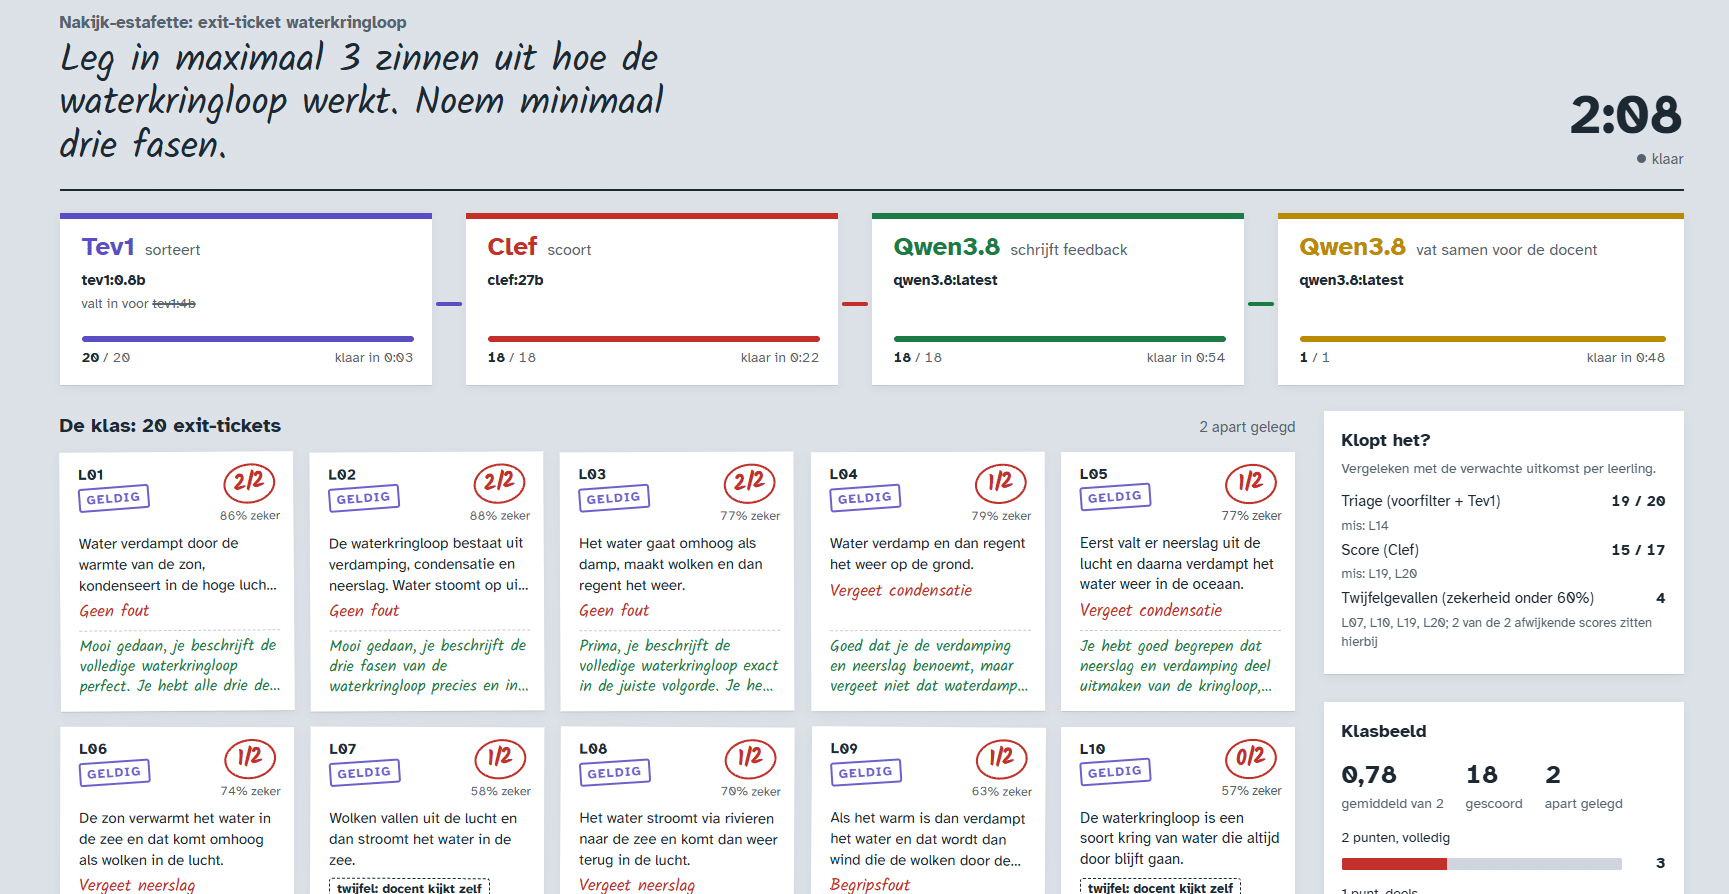
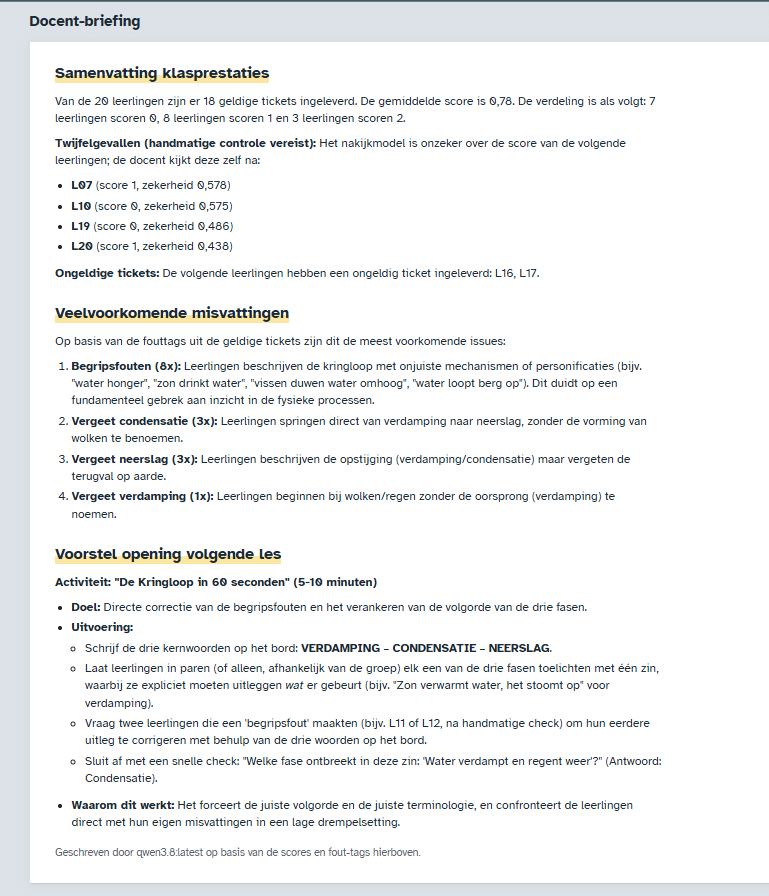
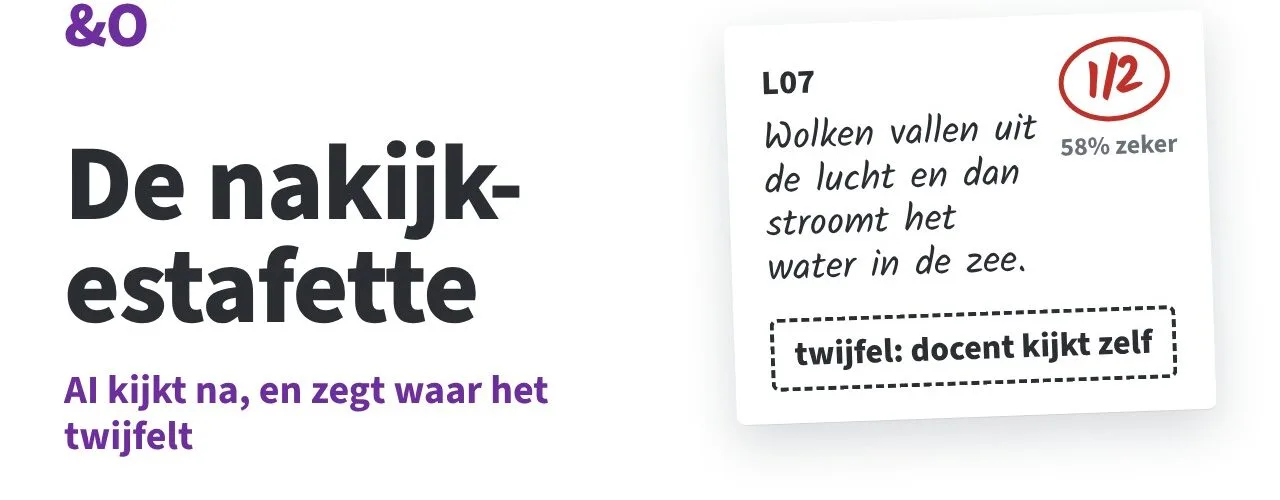
Een docent sluit de les af met een exit-ticket: leg in drie zinnen uit hoe de waterkringloop werkt. Twintig leerlingen, twintig antwoorden. Nakijken, feedback geven en bedenken waar je de volgende les mee begint.
Natuurlijk kun je dit aan Qwen3.8 geven en vragen om de 20 antwoorden na te kijken, feedback per leerling te formuleren en de docent van advies te voorzien voor de volgende les. Maar voor de demo zijn de taken opgeknipt:
Hoe dat precies gelopen is, kun je in de video hieronder bekijken.

Conclusie
Het proces opknippen bleek op deze kleine steekproef van fictieve data niet sneller dan alles in één aanroep. Vier antwoorden kregen bij de estafette echter een score waarover Clef minder dan 60% zeker was. Bij de estafette was er de mogelijkheid om dat tijdig te signaleren, bij de optie waarbij Qwen het hele traject uitvoerde was dat niet mogelijk. En het is natuurlijk niet uitgesloten dat er scenario’s zijn waarbij de verschillen wél groter zijn (grotere datasets?). Wordt dus vast nog wel een keer vervolgd. En mogelijk ook in een scenario met afbeeldingen, Clef heeft er ondersteuning voor, maar ook dan wordt het even zoeken naar een nuttig scenario.
En natuurlijk blijft het relevant om de juiste prompts mee te geven aan Qwen 3.8 als het gaat om het genereren van de feedback.
De code van het geheel is hier op github te vinden. Voor gebruik in combinatie met de NOLAI servers heb je wel een API-key nodig.